Проверка заголовков H1–H6 помогает собрать структуру страницы, найти отклонения от выбранных правил и сравнить несколько адресов. Начните с одного примера каждого типа: услуги, категории, товара или статьи. Так проще отделить проблему шаблона от неудачного текста. Назначение главного заголовка и его отличие от Title разобраны в материале об H1; здесь рассмотрим работу с отчётом.
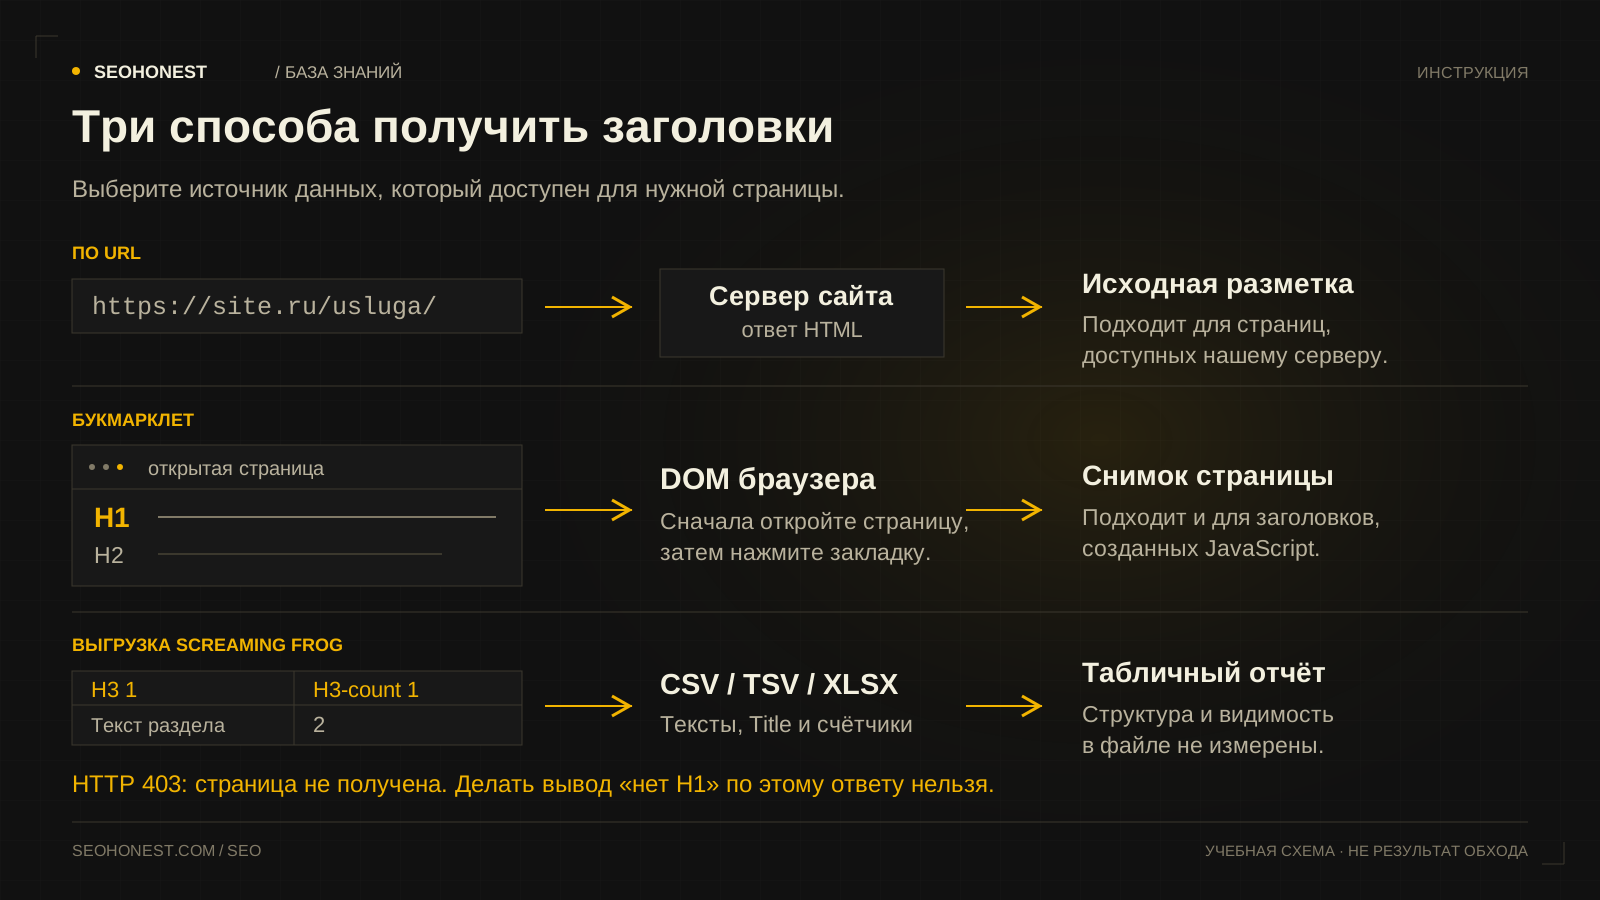
Выберите способ получения данных
- Проверка по URL подходит для публичной страницы, которую сервер может загрузить. Она анализирует полученный HTML.
- Букмарклет собирает заголовки открытой страницы после работы JavaScript. Этот способ удобен, когда содержимое в браузере отличается от исходного ответа.
- Выгрузка Screaming Frog подходит для подготовленной выборки страниц. Инструмент читает файл в браузере, без повторных запросов к указанным сайтам.
Проверьте страницу по URL
Введите полный адрес в поле «Адрес страницы» и нажмите «Проверить заголовки». Для сравнения можно указать до 20 адресов, каждый с новой строки. Используйте публичные URL без паролей и параметров доступа. Дождитесь результата: в отчёте появятся полученные снимки и отдельные причины отказов.
HTTP 403, тайм-аут или другая ошибка загрузки не означают, что на странице нет H1. Такая страница не входит в анализ заголовков. Если браузер её открывает, воспользуйтесь букмарклетом или подготовьте выгрузку. Проверка по URL не гарантирует доступ к сайтам за Cloudflare и не обходит проверку доступа. Для заголовков, которые добавляет JavaScript, нужен снимок браузера либо соответствующий режим обхода Screaming Frog.
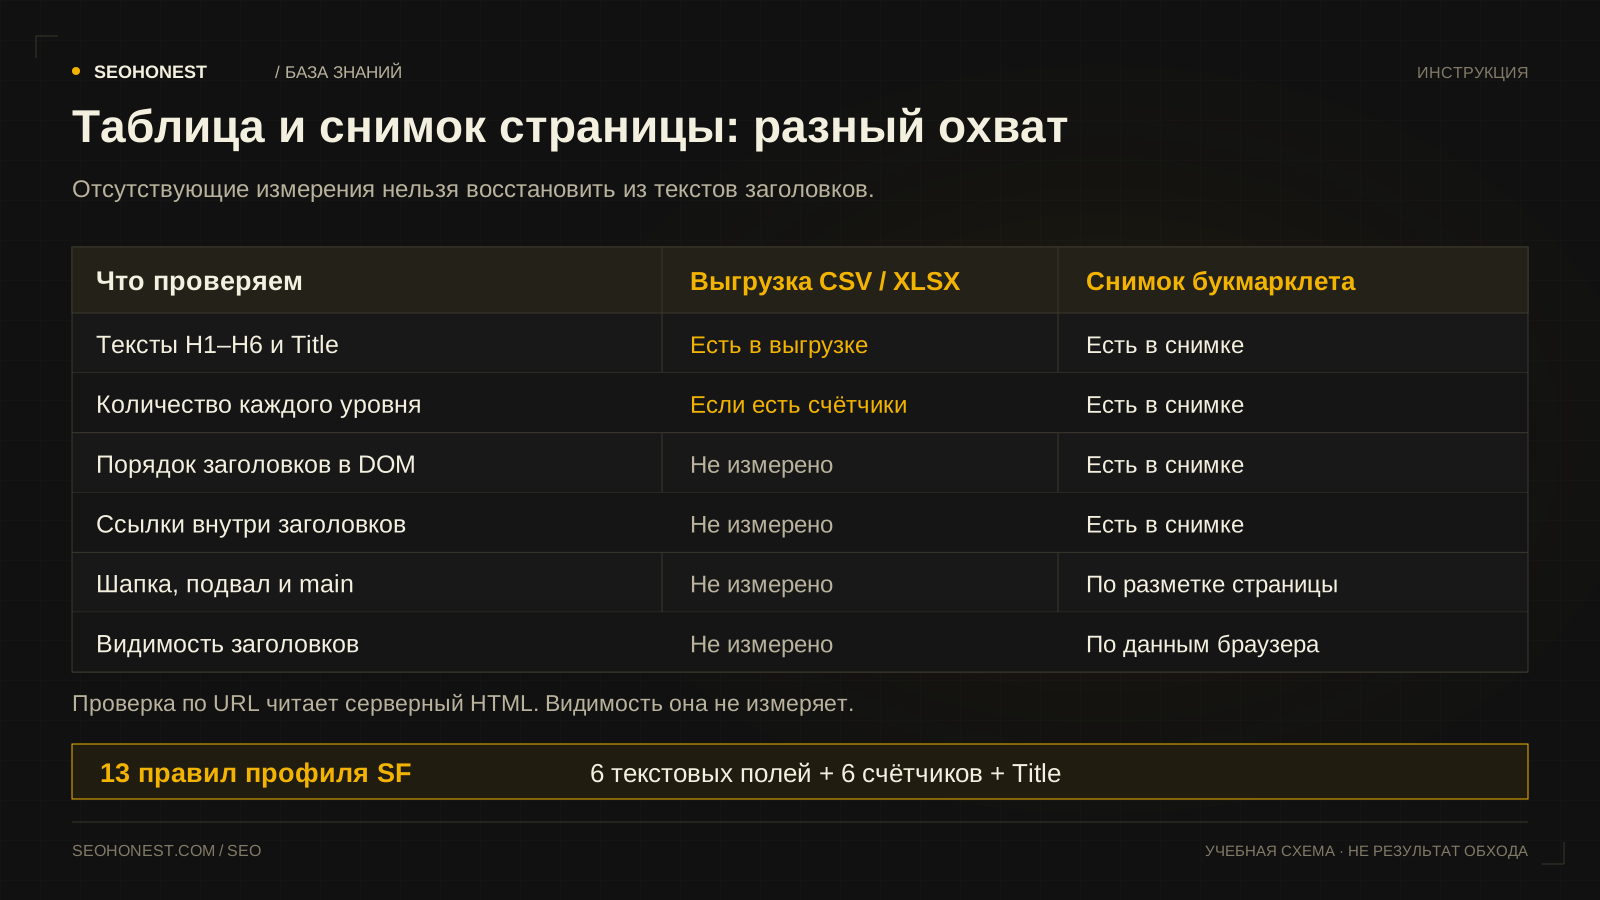
При оценке положения заголовка различайте порядок элементов и внешний вид. Стили могут переставить блоки на экране. Поэтому замечание о тексте перед H1 дополнительно проверьте на открытой странице. Для замечаний о видимости нужен браузерный снимок; исходный HTML сам по себе не показывает, что посетитель видит при конкретной ширине окна.
Соберите открытую страницу букмарклетом
- В инструменте раскройте раздел «Проверить открытую страницу: букмарклет».
- Перетащите ссылку «Проверить H1–H6» в панель закладок браузера. При необходимости используйте инструкцию «Установить вручную».
- Откройте нужную страницу, дождитесь загрузки содержимого и нажмите созданную закладку. Браузер скачает JSON-файл со снимком заголовков.
- Вернитесь в инструмент, раскройте «Продолжить работу с сохранённым отчётом» и выберите этот JSON-файл. Данные добавятся в общий отчёт.
Снимок относится к открытому состоянию страницы и размеру окна. Сначала раскройте нужные вкладки или разделы, если их содержимое появляется только после действия. Букмарклет не читает поля форм, пароли или хранилище браузера и не отправляет данные по сети. На служебных страницах и при ограничениях сайта его запуск может быть запрещён.
Настройте правила под свой проект
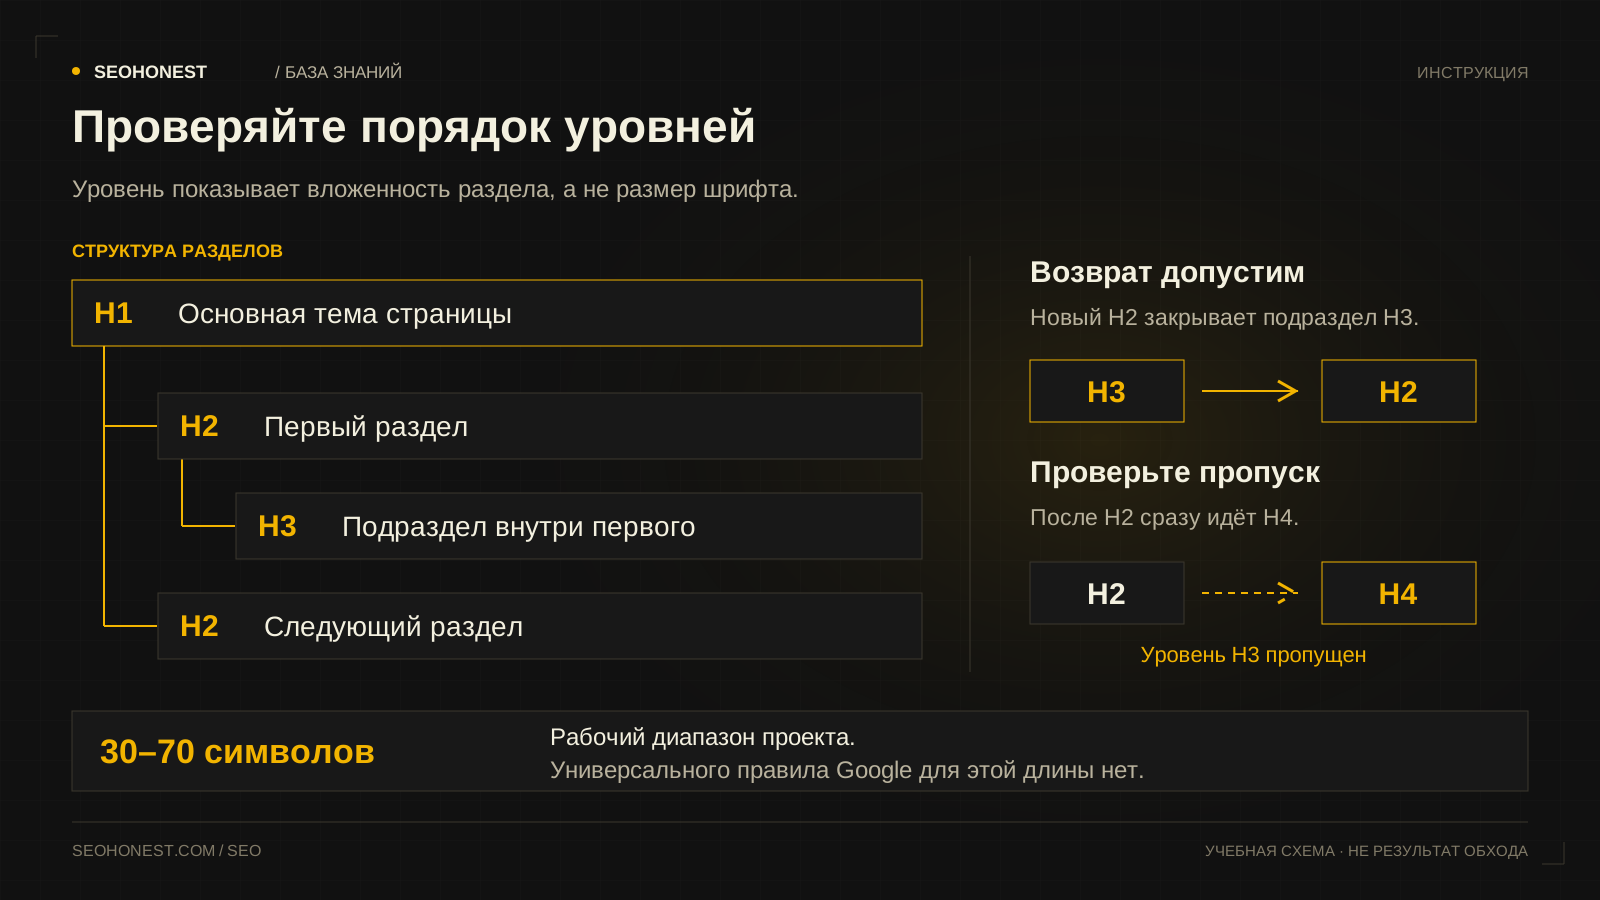
В разделе «Изменить правила проверки» выберите область: основное содержимое или всю страницу. По умолчанию диапазон длины составляет 30–70 символов, включено правило «Ровно один H1». Наличие хотя бы одного H2 или H3 можно потребовать отдельно. Эти настройки задают ваш рабочий стандарт; они не являются универсальными требованиями Google ко всем страницам.
У короткой страницы может не быть подразделов. Для подробной статьи важна понятная вложенность: H2 обозначает раздел, H3 его подраздел. W3C рекомендует учитывать уровни и по возможности избегать пропусков при переходе к вложенному разделу. Возврат от H4 к новому H2 сам по себе не нарушает эту логику.
Выберите уровни для поиска дублей и проверки ключа. Основную фразу задайте отдельно для каждой страницы в отчёте; дополнительные фразы разделяйте знаком |. Можно настроить точное вхождение и допустимую позицию начала ключа. Совпадение H1 с Title тоже можно отмечать отдельным правилом. Читабельность, смысл и уместность повторов оцените вручную: автоматическое вхождение слов этого не подтверждает.
Загрузите все H1–H6 из Screaming Frog
Для этого сценария нужна лицензия Screaming Frog с Custom Extraction. В начале инструмента есть кнопка «Скачать настройки Screaming Frog для H1–H6». Профиль уже содержит 13 правил: тексты всех шести уровней, их количества и Title. Вводить XPath вручную не требуется. Файл проверен в версии 14.2; совместимость с другими версиями не проверена.
- Сохраните свои настройки через Config → Profiles → Save As. В версии 14.2 используйте File → Configuration → Save As. Загружаемый файл заменяет полный профиль обхода.
- Выберите Config → Profiles → Load либо File → Configuration → Load в 14.2 и откройте скачанный файл
seohonest-headings-h1-h6.seospiderconfig. - Запустите обход. Профиль соблюдает robots.txt, использует обычный HTML и ограничивает обход 500 адресами. Если содержимое создаёт JavaScript, перед обходом включите Configuration → Spider → Rendering → JavaScript.
- После завершения откройте Custom Extraction и нажмите Export. Сохраните CSV или XLSX со всеми уровнями, счётчиками, Address и Status Code.
- Загрузите файл в форму «Загрузить выгрузку Screaming Frog». Проверьте назначения столбцов и нажмите «Добавить в отчёт». После работы верните свой сохранённый профиль через Load.
Поддерживаются CSV, TSV и XLSX: до 500 строк данных, 10 МиБ и 256 столбцов. Файл сверх этих пределов не импортируется. Если кириллица читается неправильно, смените кодировку; для XLSX выберите нужный лист. Профиль проверен с автоматическим распознаванием текстов, счётчиков и Title, но при другом названии столбца назначьте роль вручную. Не смешивайте Custom Extraction с обычными H1/H2 из Internal: так можно задвоить тексты.
Таблица передаёт тексты и подтверждённые количества. По ней нельзя восстановить порядок заголовков на странице, ссылки внутри них, шапку, подвал, видимость и содержимое разделов. Эти проверки останутся без данных. Если Frog получил 403 или страницу проверки доступа, заголовки нужной страницы не собраны.
Отсутствие столбца определённого уровня означает, что эти данные не передали. Оно не подтверждает отсутствие такого заголовка на сайте. Счётчики готового профиля помогают отличить ноль тегов от неизвестного количества; они учитывают и пустые теги, у которых нет текста для отдельной ячейки.
Сравните страницы и выберите исправления
Читайте замечание вместе с источником снимка. «Замечание по правилу» показывает отклонение от ваших настроек; «Ручная проверка» требует оценки редактора; «Не проверено» обозначает недостаток данных. Не превращайте каждую отметку в обязательную правку. Например, повтор короткого названия раздела на разных страницах может быть уместен.
Блок «Совпадения между страницами» сравнивает только текущую выборку и выбранные уровни после нормализации регистра и пробелов. Он не доказывает уникальность заголовка на всём сайте. Сначала сравните назначение страниц, затем предложите текст. Google учитывает главный видимый заголовок среди источников заголовка результата поиска, но отчёт не предсказывает изменение позиций.
Сохраните результат для работы
Кнопка «Скачать таблицу (CSV)» готовит таблицу для просмотра и передачи исполнителю. «Сохранить отчёт (JSON)» сохраняет данные для продолжения в этом инструменте. Позже загрузите JSON через раздел сохранённых отчётов. Такой импорт возвращает сохранённые наблюдения, а не выполняет новую проверку сайта. После публикации исправлений соберите свежие данные и сравните те же адреса при сопоставимых условиях.
Источники и документация
- W3C: уровни и структура заголовков.
- Google: формирование заголовков результатов поиска.
- Screaming Frog: извлечение заголовков.
- Screaming Frog: сохранение и загрузка профилей.
Проверить свои страницы
Откройте инструмент, выберите источник данных и настройте правила под свой проект.